标签: AI实验室
- 作者帖子

sxwqh游客
未曾管理员更新4.1
核心图像引擎全面集成专业级 PyMuPDF 引擎。
多图层 PDF 底图穿透提取。
原生支持 JBIG2 单色古籍无损提取。
消除大型动态库重复打包。
sxwqh游客未曾先生好!
我用4.1版试了一下,昨天那个含有551个双面书页的pdf,裁切很成功,裁切后的pdf中是1102个单面书页了。
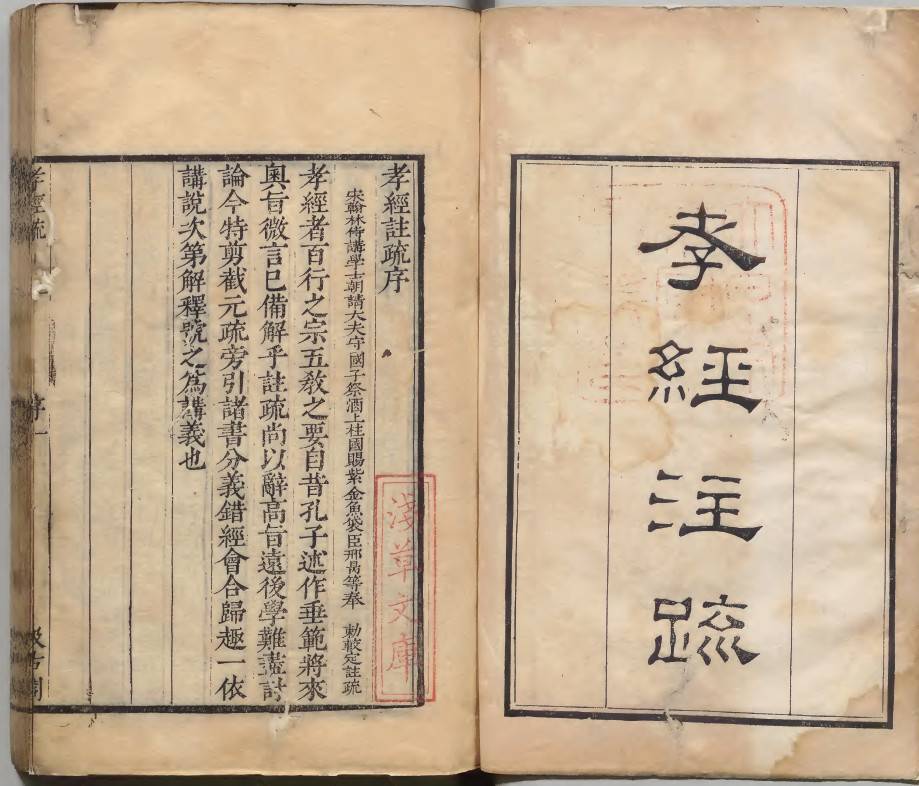
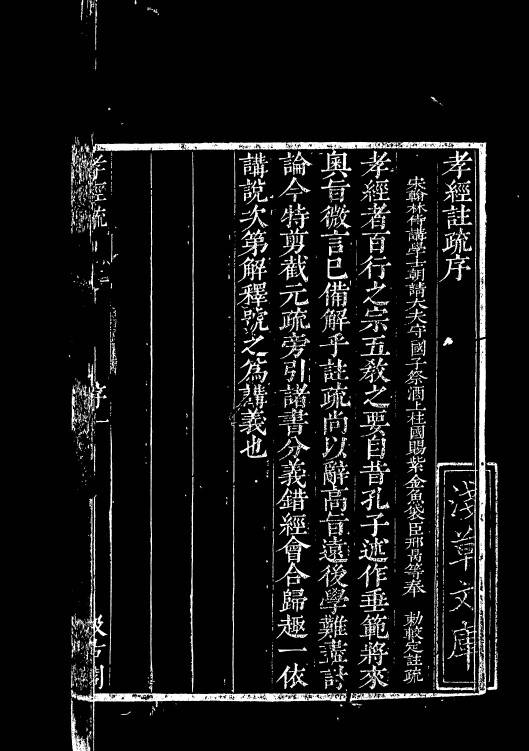
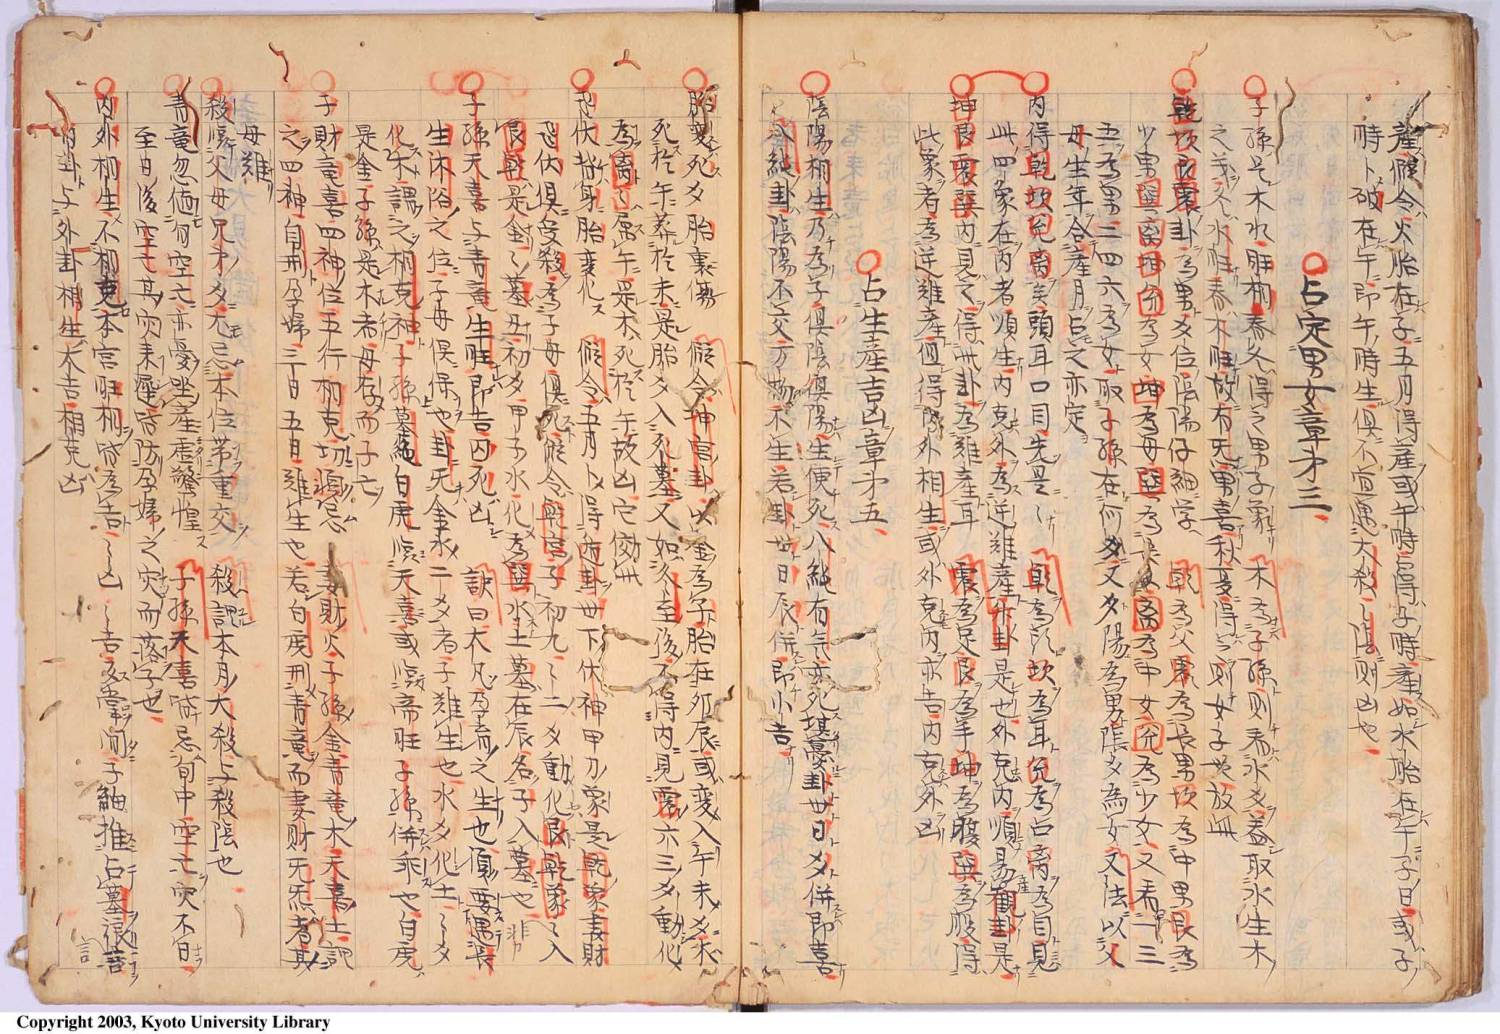
我又裁切了一下从内阁文库下载的十三经注疏。前几天,用老版本裁切,裁切后的书页上象是蒙了一层纱,书页上的字完全看不了。今天用4.1版裁切,裁切后书页上的字能看到了,但却是黑白反相的(字是白的,底是黑的,正常应该是字黑底白)。
这是处理前的:

这是裁切后:
要是能解决这个问题那就更好了。
sxwqh游客通过网盘分享的文件:十三经注疏-孝经-校訂者毛晋(明)-清嘉慶03年[旧蔵者]昌平坂学問所.pdf
链接: pan.baidu.com/s/1Zi...w?pwd=ymph 提取码: ymph
未曾管理员@sxwqh #221955
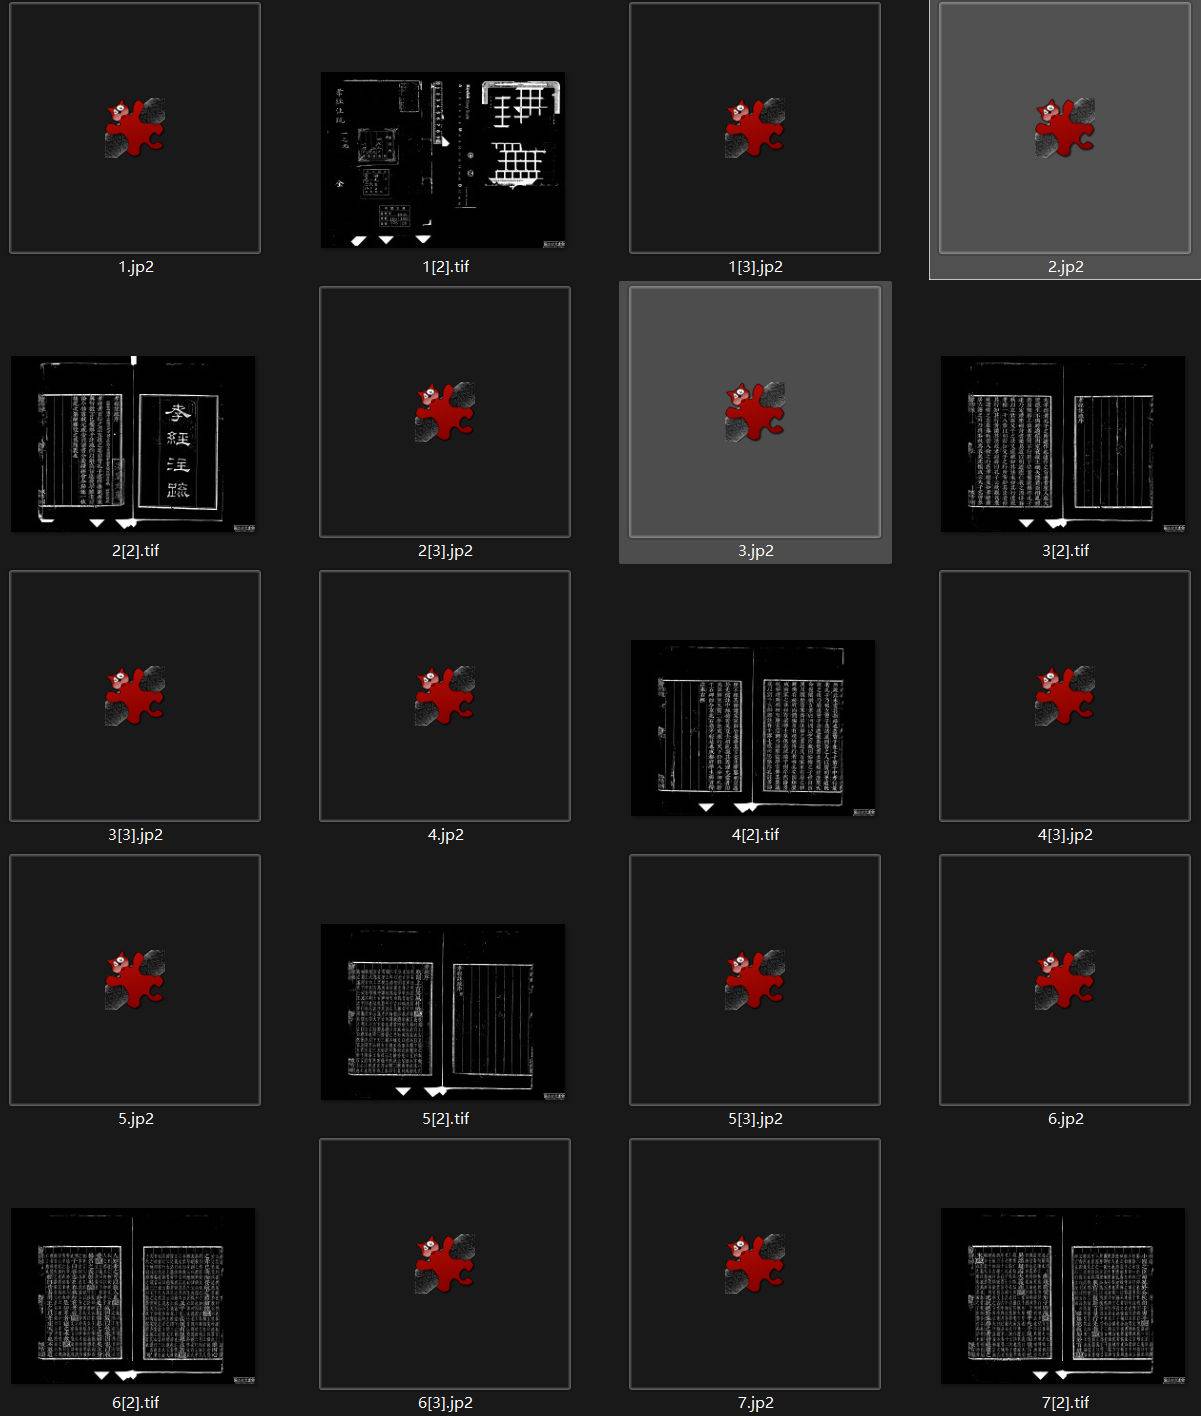
提取了这个文件的数据发现内阁这种早期的文件有三层,底层是颜色,第二层是文字,第三层好像是光线之类的
第二层本来就是这种白黑的,我的建议是重新下新的文档
sxwqh游客@未曾 #221956
好的,谢谢未曾先生!
我是前些天从交流区书友分享的百盘网盘“铭心阁识辨辑”-“日本内阁文库”-“内阁文库古籍藏书【524GB·31700册】(第二库)“中下载的清嘉慶3年《阮刻本十三经注疏》,这种pdf打开的速度很慢,但书页上的文字看着还比较清楚。
要重新下载新的文档,不知道在哪里可以下载?不知有没有哪位书友可以在百度网盘共享一下?
sxwqh游客铭心阁识辨辑:https://pan.baidu.com/s/1EoluAOL47O_NiPSi8XmqxA?pwd=c53i#list/path=%2F&vmode=list
sant3游客@未曾 #221956
PDFPatcher/ComicEnhancerPro 在处理PDF图像时都有“反转黑白图片的颜色”等选项
sxwqh游客
未曾管理员
未曾管理员@sxwqh #221954
针对内阁这种早期的数字文件我们新增了“深度处理”模式(解决多层 PDF 渲染问题),但是速度偏慢。
程序会自动把所有图层内容合成为您在阅读器中肉眼看到的完整页面,文字与图画完整无缺,然后再做后续裁切或转换。
因此,此模式也可以处理非纯图的PDF文件。@sant3 #221962
感谢建议~
- 在色彩处理中新增了反相二值化(黑白)图片选项(默认不勾选)。
- 勾选后,程序在完成黑白二值化处理的同时,会自动将黑白两色反转(如把“白底黑字”翻转为“黑底白字”),满足夜间阅读或特殊文献制图的需求。
@sxwqh #221970
优化页面处理速度(根据PDF自动选择核心处理组件)
更新版本 V4.2
新增“深度处理”模式(解决多层 PDF 渲染问题)
新增“反相黑白(二值化)”选项
优化页面处理速度(根据PDF自动选择核心处理组件)
sxwqh游客@未曾 #222002
未曾先生好!
我用4.2版试着处理了一下昨天用4.1版处理不了的从内阁文库下载的“十三经注疏-孝经”,这个pdf文件共含84个双面书页,大小是16.7m,处理的情况如下:
1.不开启“颜色处理”,选择“深度处理”模式,选择“分页处理”进行裁切。处理的过程用时很长,大约用了好几十分钟,完成后的pdf中有168个单面书页,是正常的白底黑字,但pdf文件变大了十多倍,成了199m。
2.开启“颜色处理”,不选择“深度处理”模式,但勾选“反相二值化(黑白)图片”,选择“分页处理”进行裁切,处理过程只有几分钟,完成后的pdf中也是168个单面书页,也是正常的白底黑字,pdf文件大小为14.3m。
3.开启“颜色处理”,选择“深度处理”模式,不勾选“反相二值化(黑白)图片”,选择“分页处理”进行裁切,处理过程略长一点,但也还比较快,完成后的pdf中也是168个单面书页,也是正常的白底黑字,pdf文件大小为14.9m。
4.开启“颜色处理”,选择“深度处理”模式,也勾选“反相二值化(黑白)图片”,选择“分页处理”进行裁切,处理过程用时与第三种方式差不多,完成后的pdf中也有168个单面书页,但却是黑底白字,pdf文件大小为14.9m。
结论:4.2版将原色双面书页裁切处理成黑白单面书页,不论是处理的速度还是效果,都是不错的。但在保持原色不变,只是裁切成单页的情况下,速度有点慢,而且处理后的文件变大了很多。要是能将处理速度提高一些,处理后的文件不要比原文件更大或大太多,那能就更好了。
未曾管理员@sxwqh #222019
这个文件,可以选择 要深度处理 然后转成黑白文件(这样的转换后的文件更好)。
或者不选择深度处理 选反色处理就行(可能会有信息丢失)因为内阁以前的是高压缩比的jp2分层文件,转换后为普通的JPG,肯定会变大。所以这种文件不建议转成原色了,主要是转黑白。
这个深度模式其实相当于把PDF先转成图,再做处理。避免的是非纯图页面在页面提取时的信息丢失。
sxwqh游客@未曾 #222021
好的。谢谢!
sant3游客@未曾 #222021
感谢更新~祝管理员节日快乐~~~
另外,建议其他朋友在用这个工具之前不妨先用ComicEnhancerPro 处理图像(可以转jp2文件为jpg)。
需要考虑本软件的定位,如果计划逐步增加与ComicEnhancerPro重叠的各类功能features,那可否保留一个较为单纯的切割版本(例如3.8那样的功能)
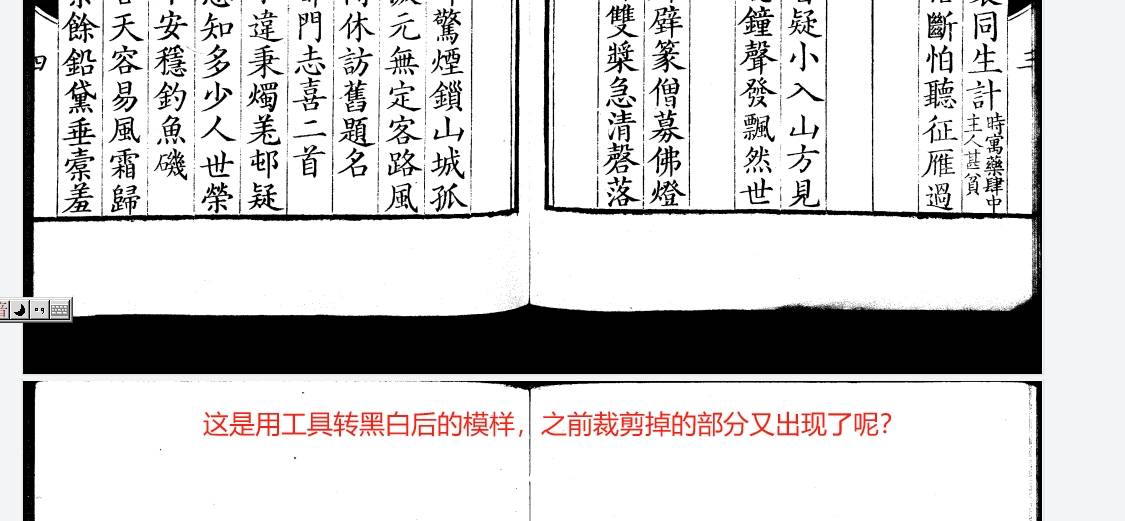
无悔游客请问未曾老师,什么剪裁后的PDF黑白转后,被裁剪的部分又出来了呢?
无悔游客@未曾 #222021
请问未曾老师,为什么剪裁后的PDF黑白转后,被裁剪的部分又出来了呢?
无悔游客@未曾 #222021
请部未曾老师,这个问题怎么解决?谢谢!
村长游客@未曾
希望可以增加一个功能,专门清除文字上的红色线条。转换成黑白后,红线变黑线,很影响阅读。
- 作者帖子