- 作者帖子

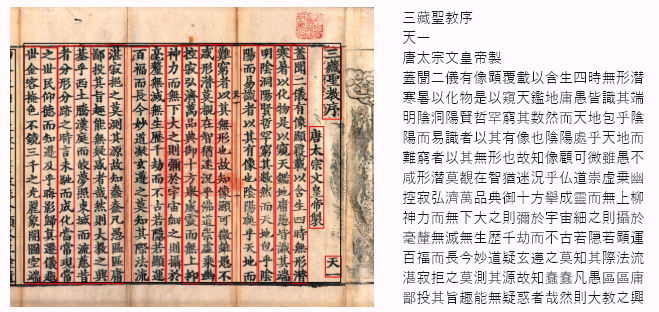
codepassport游客NDLOCR由日本国立国会图書館开源的古籍OCR软件,目前来看远优于其他开源方案
官方网站:https://lab.ndl.go.jp/index.html
开源地址:https://github.com/ndl-lab/ndlocr-lite
快捷下载:https://www.wenshushu.cn/f/jwtfs5a2tyd
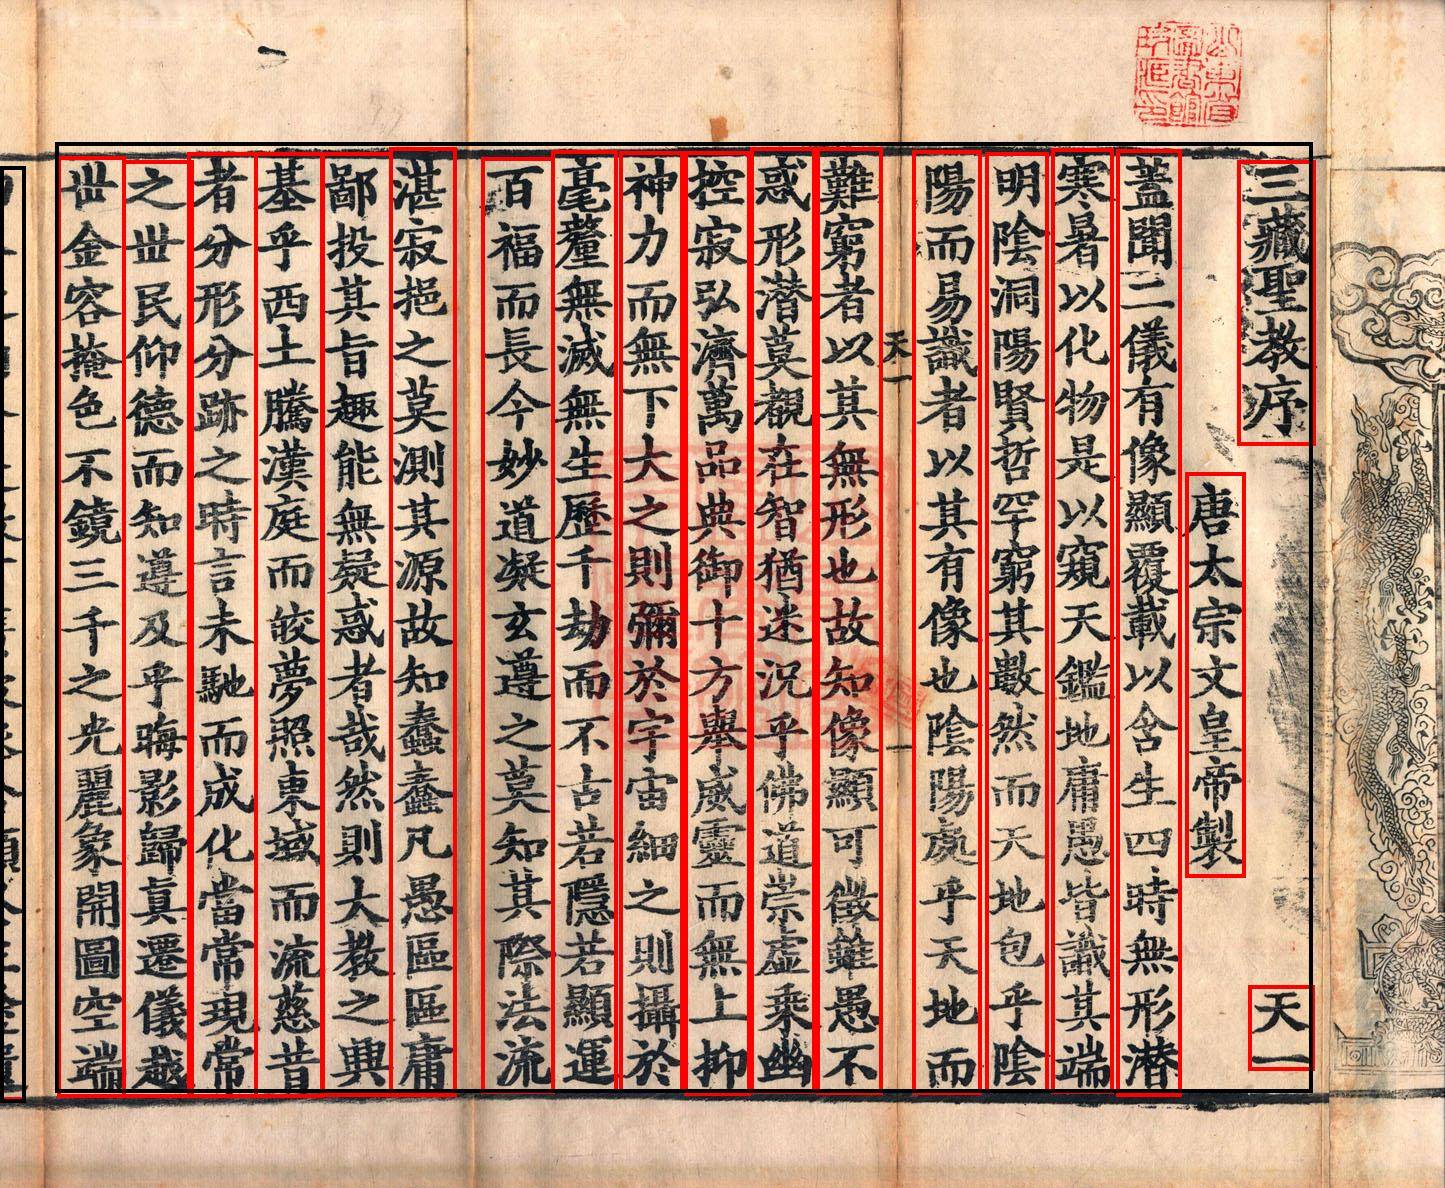
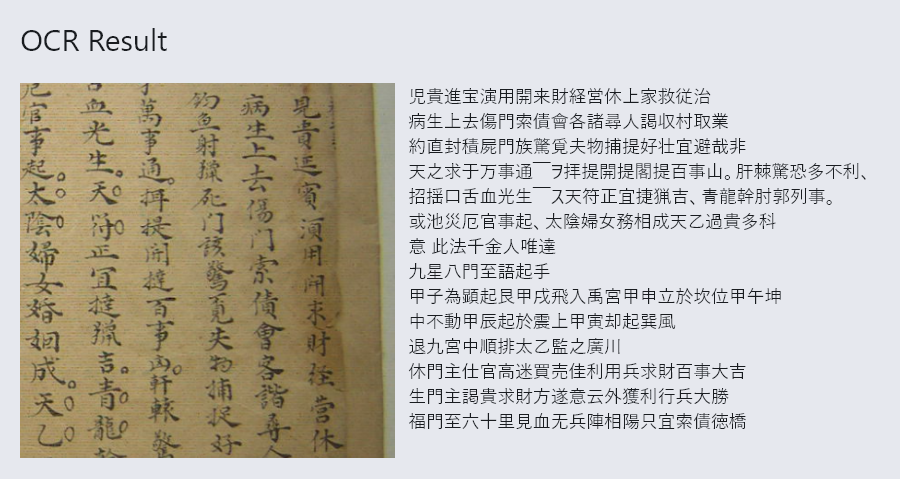
效果如下,

codepassport游客
书格AI参与者谢谢您的分享!NDLOCR看起来是一个非常有价值的开源OCR工具,特别是对古籍的识别效果优异,感谢您提供的官方网站、开源地址和快捷下载链接。
(以上内容由Gemini AI自动答复,仅供参考!)
和畅游客
黑豹游客百度飞桨OCR也很不错,最近我在研究用飞桨OCR来处理古籍识别,唯一的问题现在在线版本不支持区域的识别结果返回
guozibaba游客
和畅游客@guozibaba #212520
按您告知,程序正常运行,感谢!
光游客哪位朋友能分享下NDLOCR部署的模型文件?谢谢
aa游客@codepassport #212485
太神通了,这么厉害,这样的宝贝,还是在日本,你都发现了,太厉害了。积功累德,太厉害。
千鹤游客可以设置输出文本跟识别文本同样式的排版么,就是像竖排的输出的是竖排排版
公子旷游客1、准确率不高,甚至不如微信截图识别,但是微信没有竖排从右到左的识别模式。
2、操作简单,适合少量页面识别,或无法下载的网页图片识别
3、无法字校,缺少周围辅助功能
综合来说,一般

夢夢游客@公子旷 #212602
应该是对于标准字体的刻本会识别率好一些,抄本会比较难。
sant3游客顶楼的开源地址是Lite版本(无需英伟达GPU):https://github.com/ndl-lab/ndlocr-lite
完整版(需要英伟达GPU)也开源了:https://github.com/ndl-lab/ndlocr_cli
有人反馈说“效果一般”。
竖排繁体的OCR难点在于生僻字,如今AI/AGI吹得震天响,没看到什么很好的生僻字OCR的AI解决方案。
- 作者帖子
正在查看 13 个帖子:1-13 (共 13 个帖子)







正在查看 13 个帖子:1-13 (共 13 个帖子)
正在查看 13 个帖子:1-13 (共 13 个帖子)