- 作者帖子

黑豹游客接触古籍不算太长也不算太短,说说我遇到的几个。
故事要从一页扫描得歪歪扭扭的古籍PDF说起。
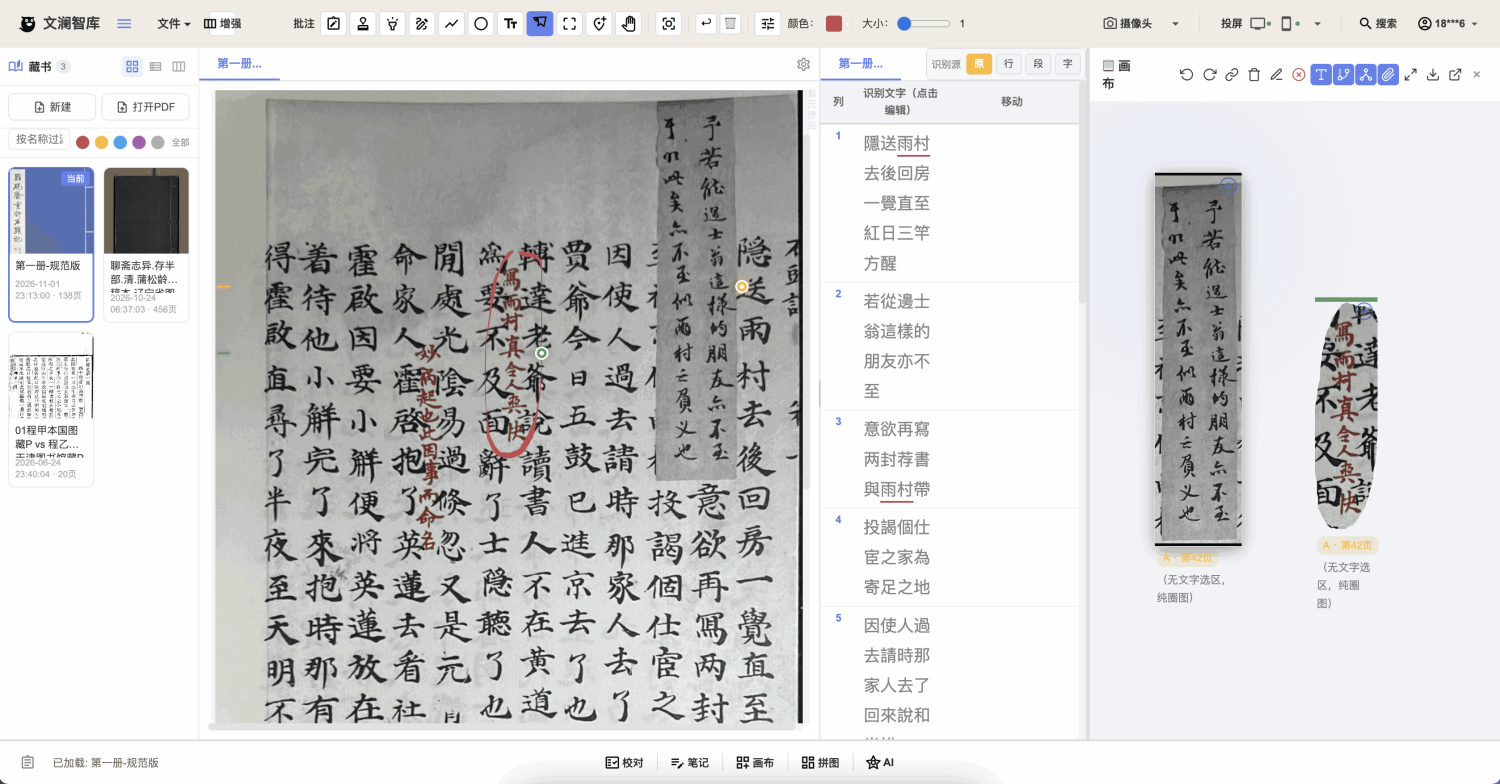
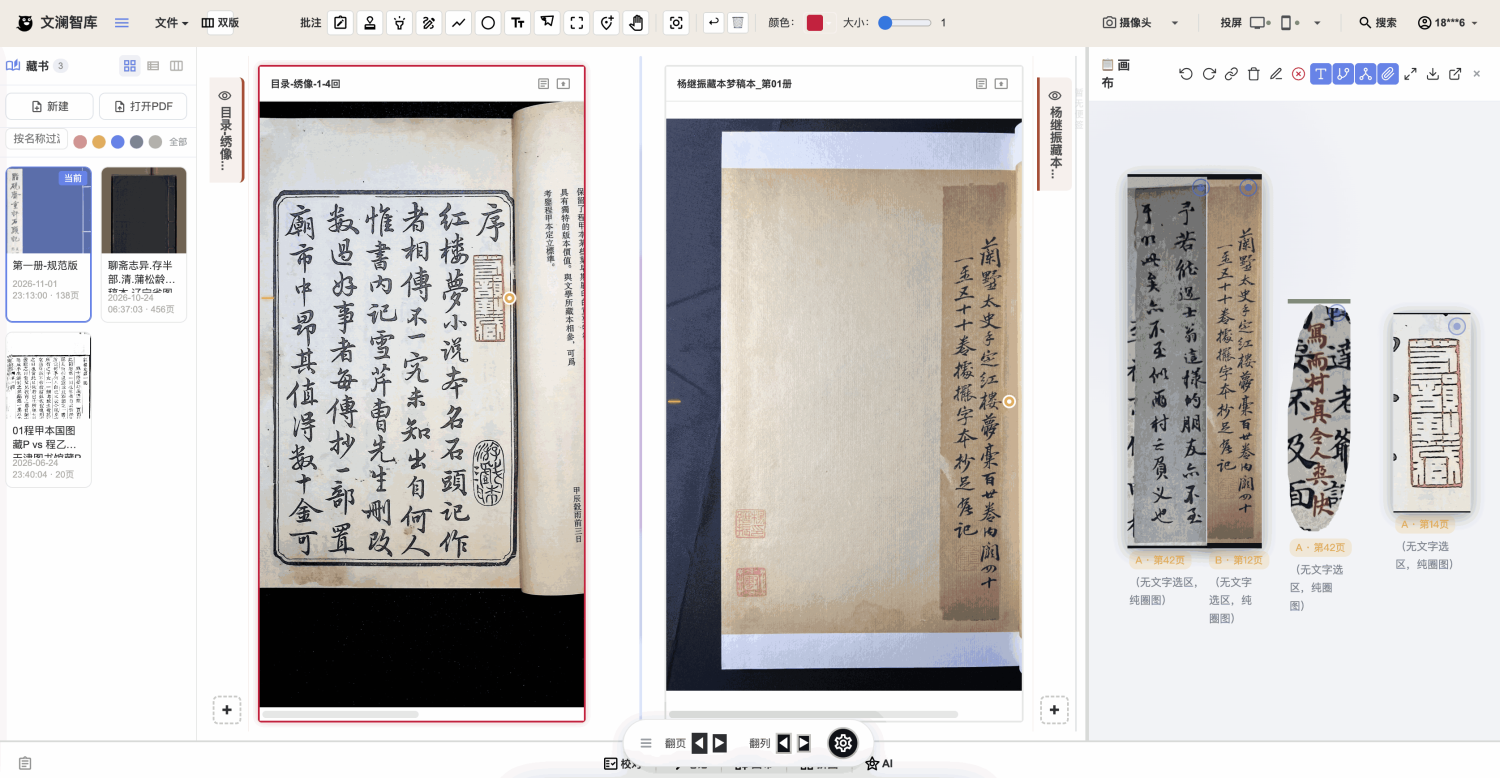
做古籍数字化的朋友大概都懂那种时刻:桌上摊着两个版本的同一部书,一个影印本,一个整理本。你眼睛在屏幕上左右横跳,逐字比对,"之""乎""者""也"看得人眼花——不是不专注,是人眼干不过来。识别引擎吐出来的文字,版面切得七零八落,正文注文混在一起,你花在"整理识别结果"上的时间,比读书本身还多。
我当时就想,这活儿不该是这样的。
爱书之人,其实都明白一个道理:藏书、读书、传书,从来是一件事。 古人藏书楼里校书,批注写在书眉上,一代人把批过的本子传给下一代——藏是为了读,读透了才有得传。这三件事被拆开,是纸的时代不得已;到了数字时代,我们明明有条件把它们重新合在一起,可市面上的工具,存文件的不管读,做阅读的存不下心得,读通了的东西又很难原汁原味地递给下一个人。
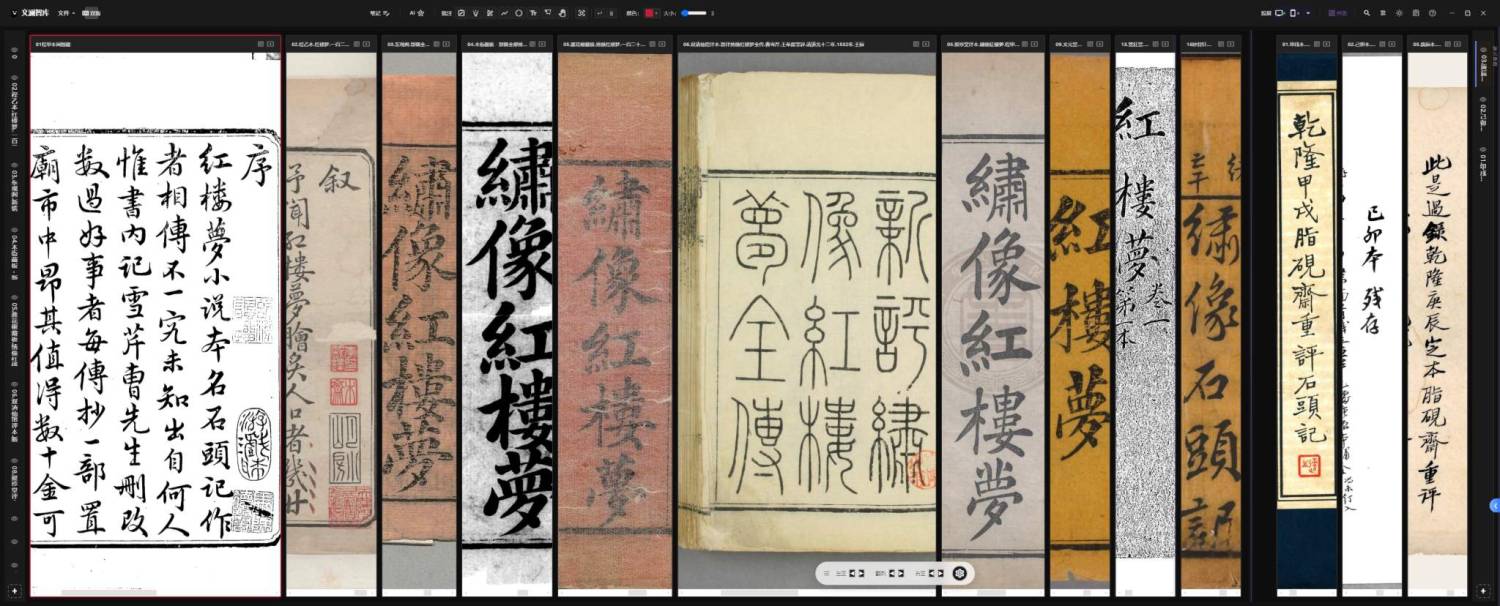
于是有了文澜智库。我想做的事只有一件:让"藏读一体"在数字时代重新成立——藏读一体,学习一生。
先说藏。 古籍资料不出本机——它是完全离线运行的桌面应用,你的扫描件、识别文本、批注笔记,全部留在自己的电脑上。藏书人的第一守则,是书在自己的手里。这一点我很固执。
再说读。 我最初只是解决一个最朴素的问题:双版本A/B校对。左右两栏并排,PP-OCRv5先把版面结构读清楚——哪里是正文、哪里是夹注、哪里是栏外批语——再用专门面向古文的识别模型把字认出来。你的眼睛终于不用横跳了,差异会自己浮出来。而古文的智能实体识别,人名、地名、官职不再是糊成一团的字符——通用模型读不懂古文,所以我专门为古文调教了一双眼睛。
读进去了,就该有心得可留。 用着用着,需求自己长了出来:想在页边写点什么,写了还想让它跟原文某一句永远绑在一起——所以有了锚定原文的批注卡片;批注多了想理出脉络,想把两处笔记连起来说"这里和那里呼应"——所以有了那块能连线的无限画布,卡片之间拉着线,像给一部书织了一张自己的网。这不就是数字时代的书眉批语吗?只是它比纸页能承载的,多得多。
最后是传。 古人传书,靠抄写、靠刻版、靠一代代递下去的批校本。今天传书可以更远:把校对好的稿子变成播客,通勤路上也能"听"一段昨天校的书;导出的批注与原文永远对得上,下一个读到这部书的人,能顺着你的批注走一遍你走过的路。藏书楼里的灯,就这样一盏一盏传了下去。
这也是"学习一生"的注脚:书会一直藏下去,人会一直读下去,心得会一直传下去——一部古籍的生命,不该止于扫描完成的那一天。
整个过程没有什么宏大蓝图。它就是这样一小块一小块长出来的:每加一个功能,都是因为我自己(还有身边做整理的同好)真的被卡在那一页纸上过。
如果你也整日和扫描件、识别文本、繁简校勘打交道;如果你也曾希望,自己读过的书不只是躺在硬盘里,而是读透了、批过了、能递下去了——欢迎看看它。
文澜智库:藏读一体,学习一生。
黑豹游客
- 作者帖子
正在查看 2 个帖子:1-2 (共 2 个帖子)

正在查看 2 个帖子:1-2 (共 2 个帖子)
正在查看 2 个帖子:1-2 (共 2 个帖子)